
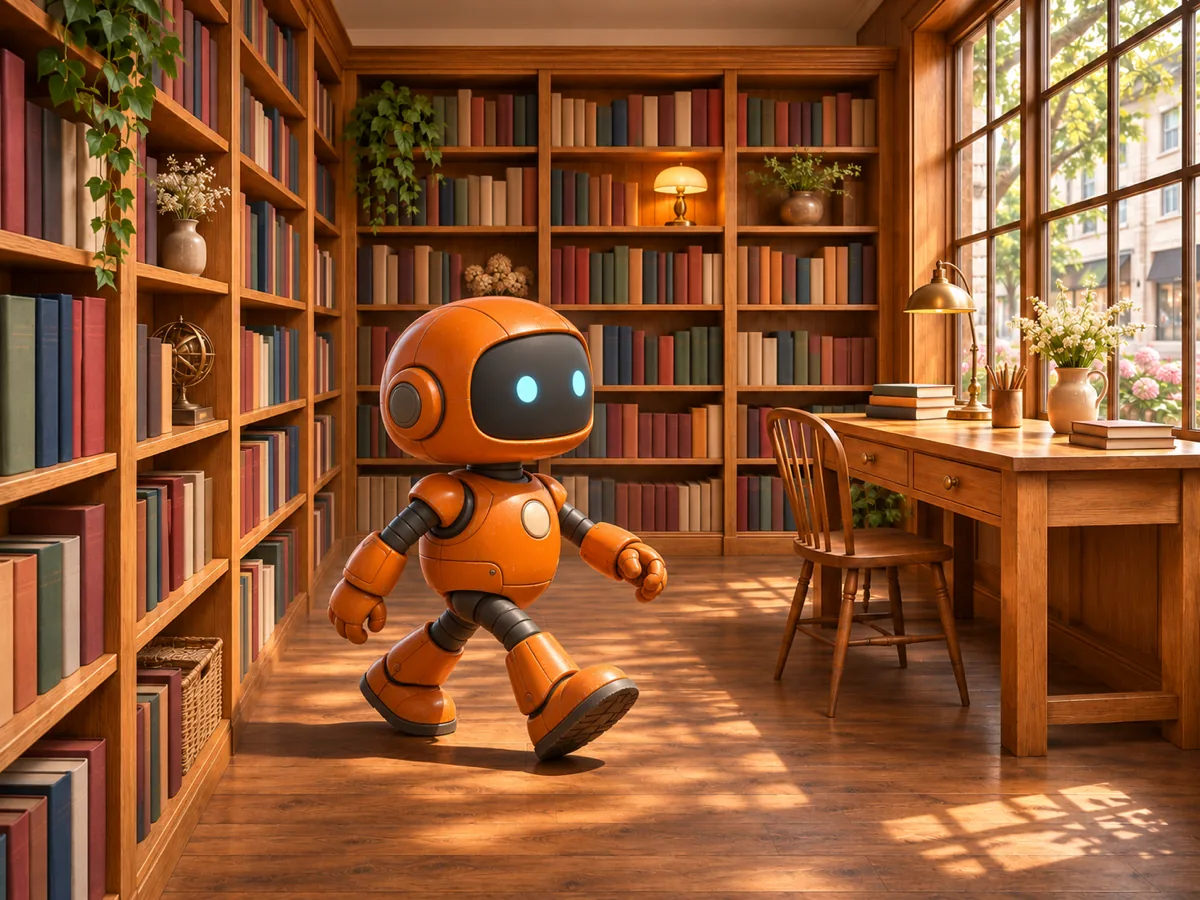
Un robot orange marche jusqu’au bureau d’une librairie
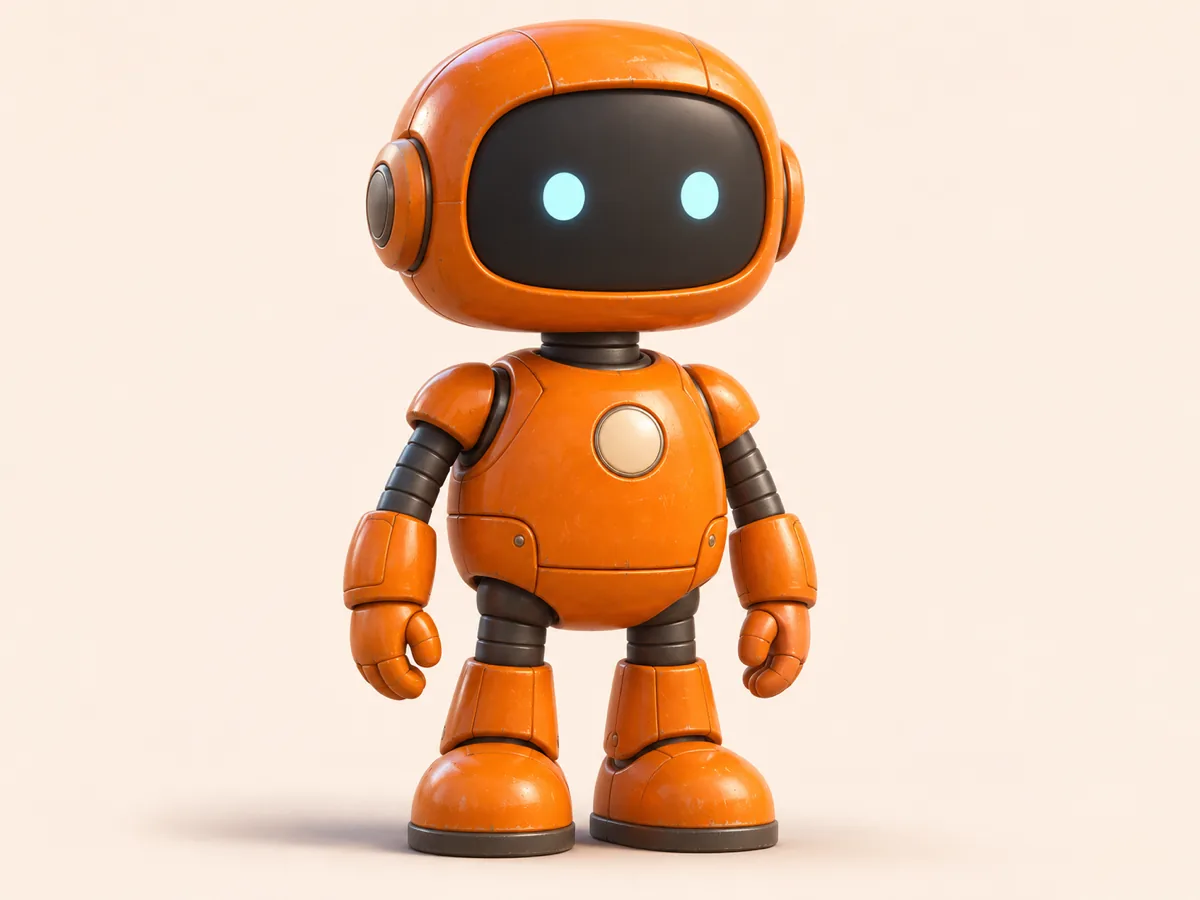
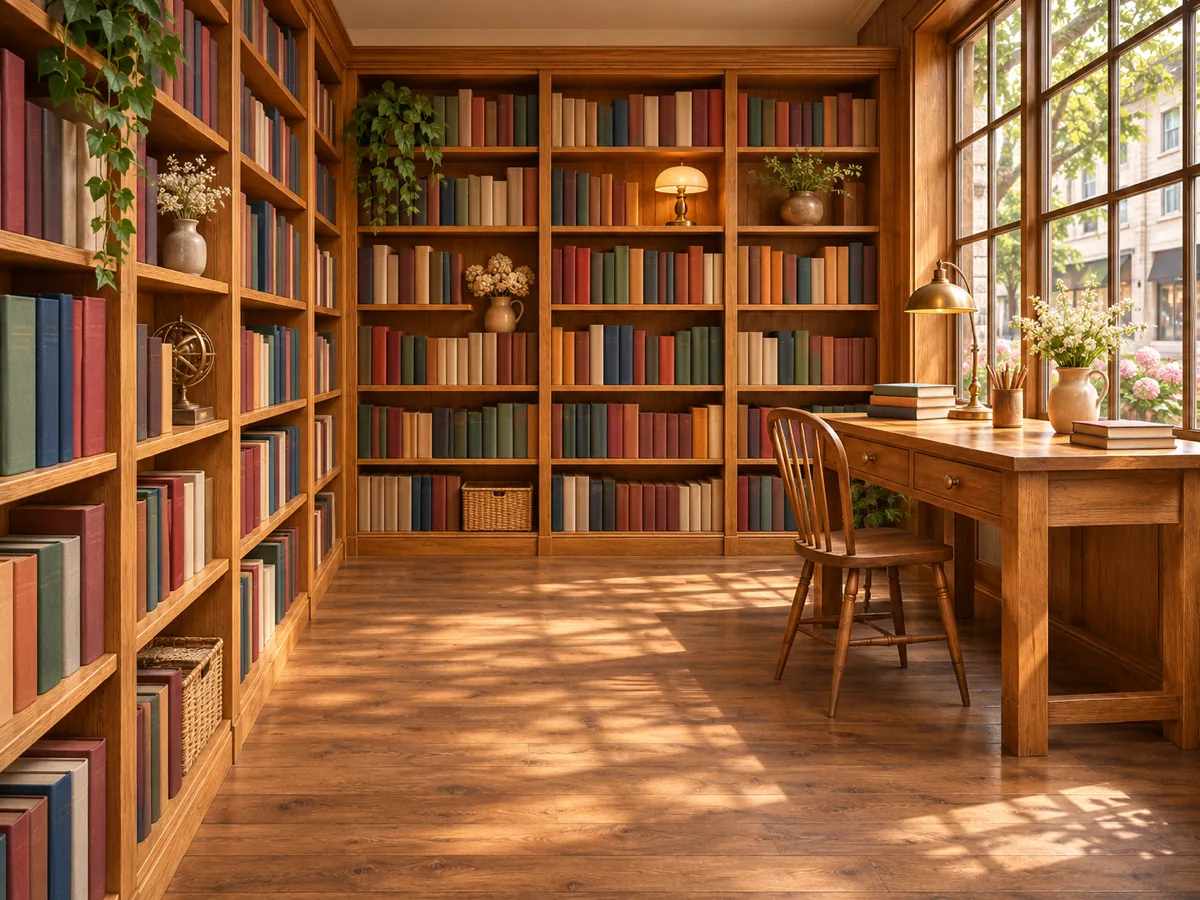
Le robot orange marche jusqu’au bureau en bois. Gardez la couleur du robot et la librairie reconnaissables.
Réglages vidéo suggérés : Veo 3.1 Fast · 8 secondes · 16:9 · 2 références
La référence en vidéo utilise des photos d’un personnage, d’un produit et d’un lieu comme guides pour un nouveau plan. Importez une à trois images, dites ce que chacune représente, et téléchargez un clip de 8 secondes.
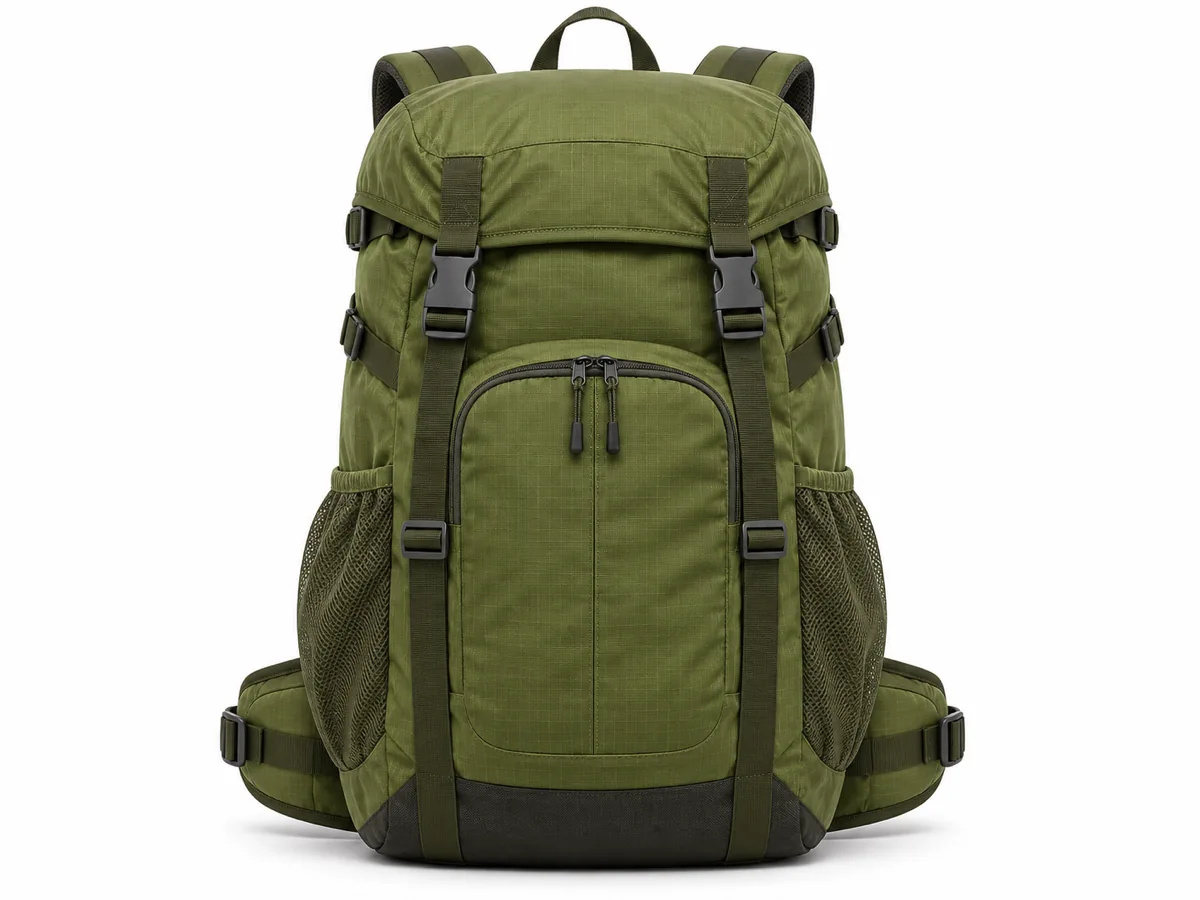
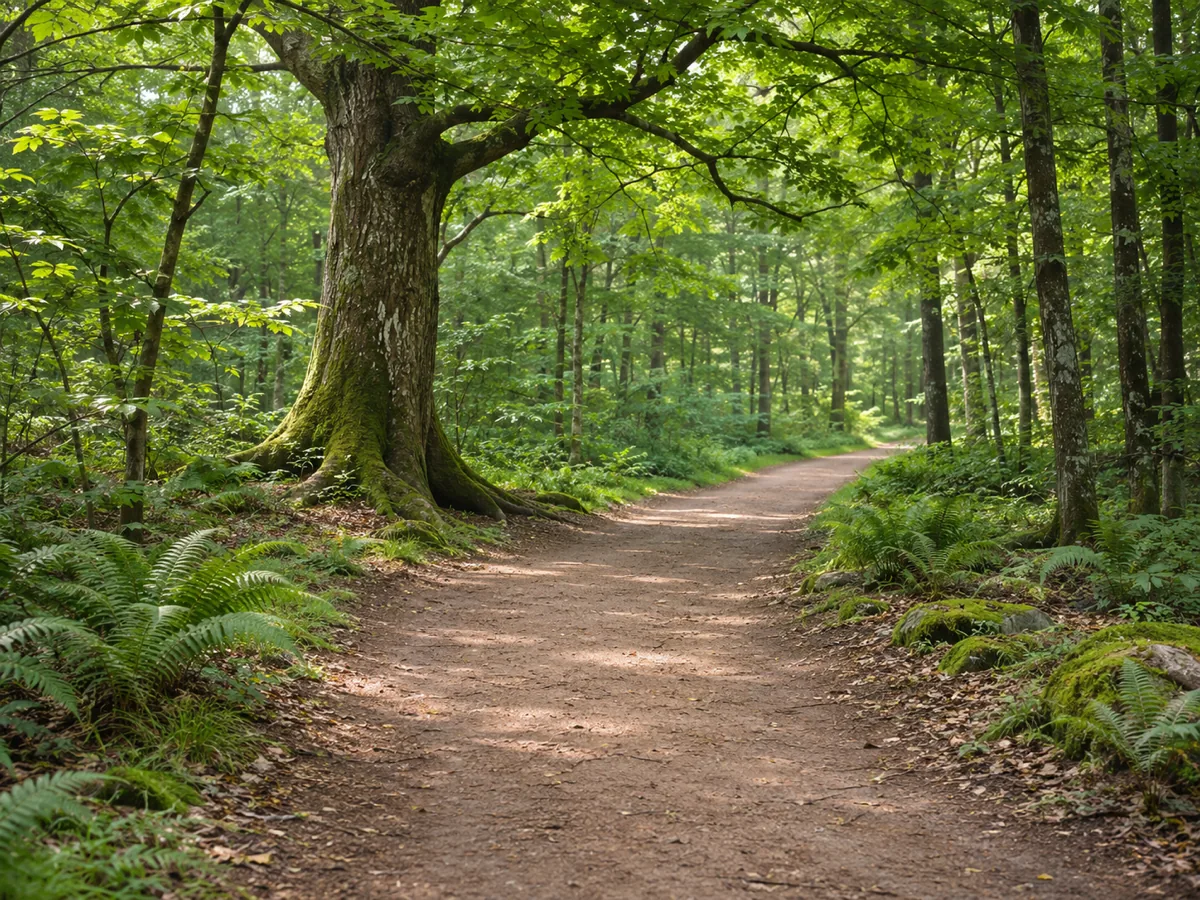
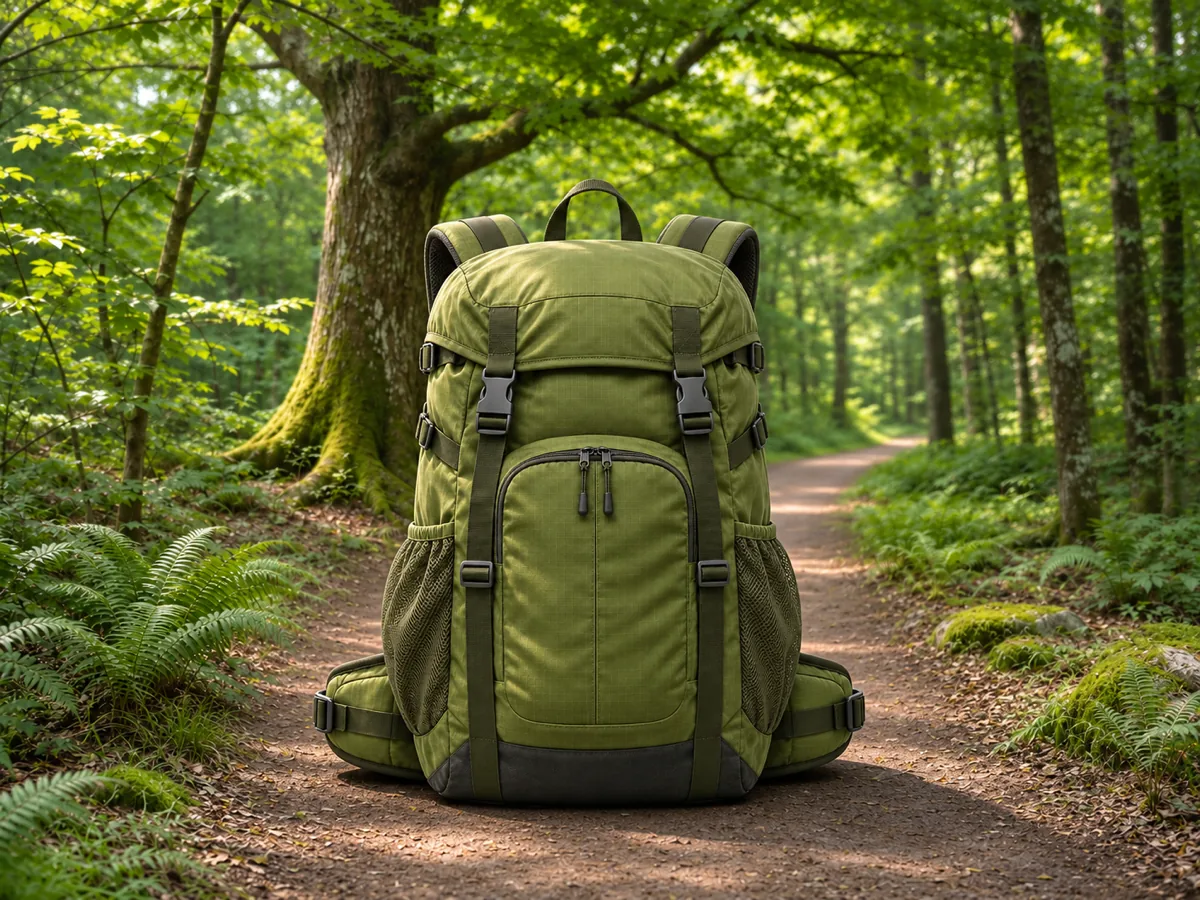
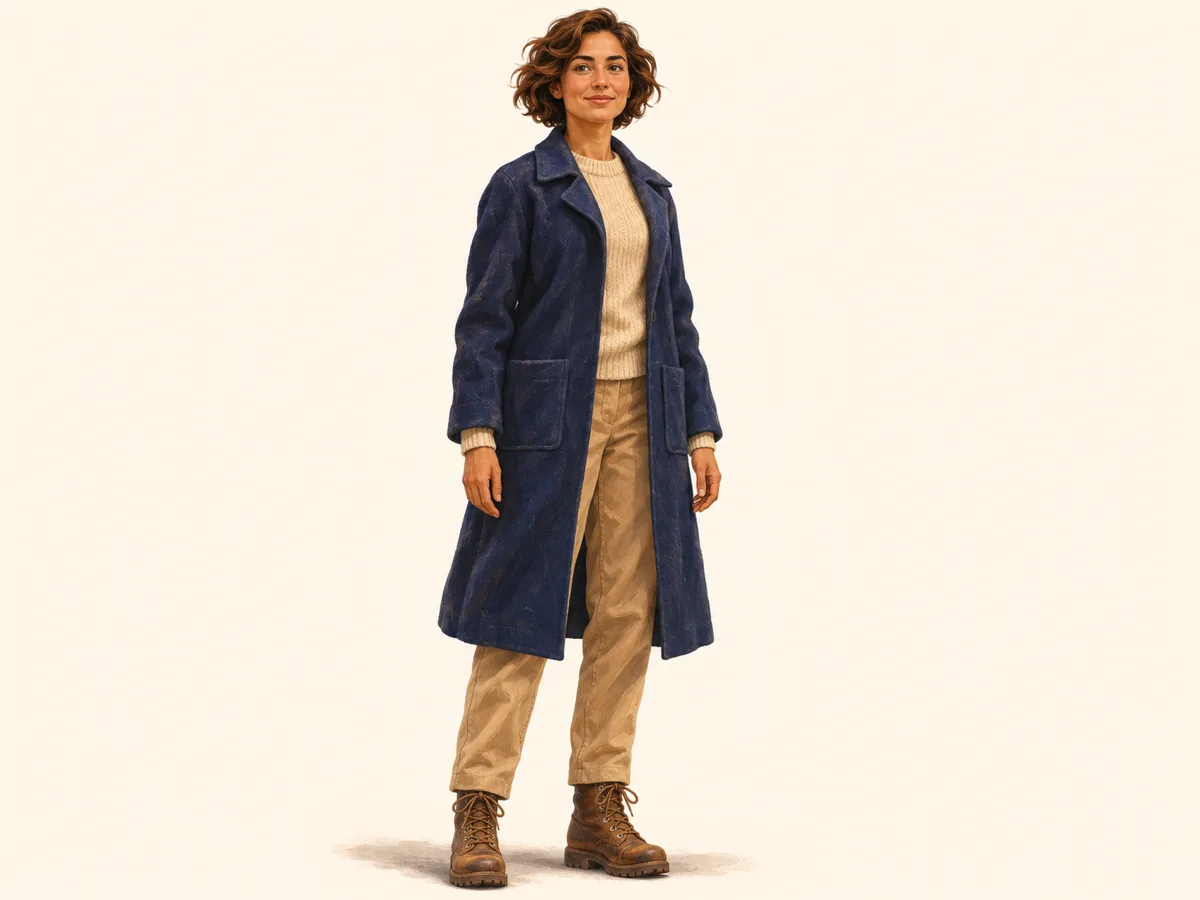
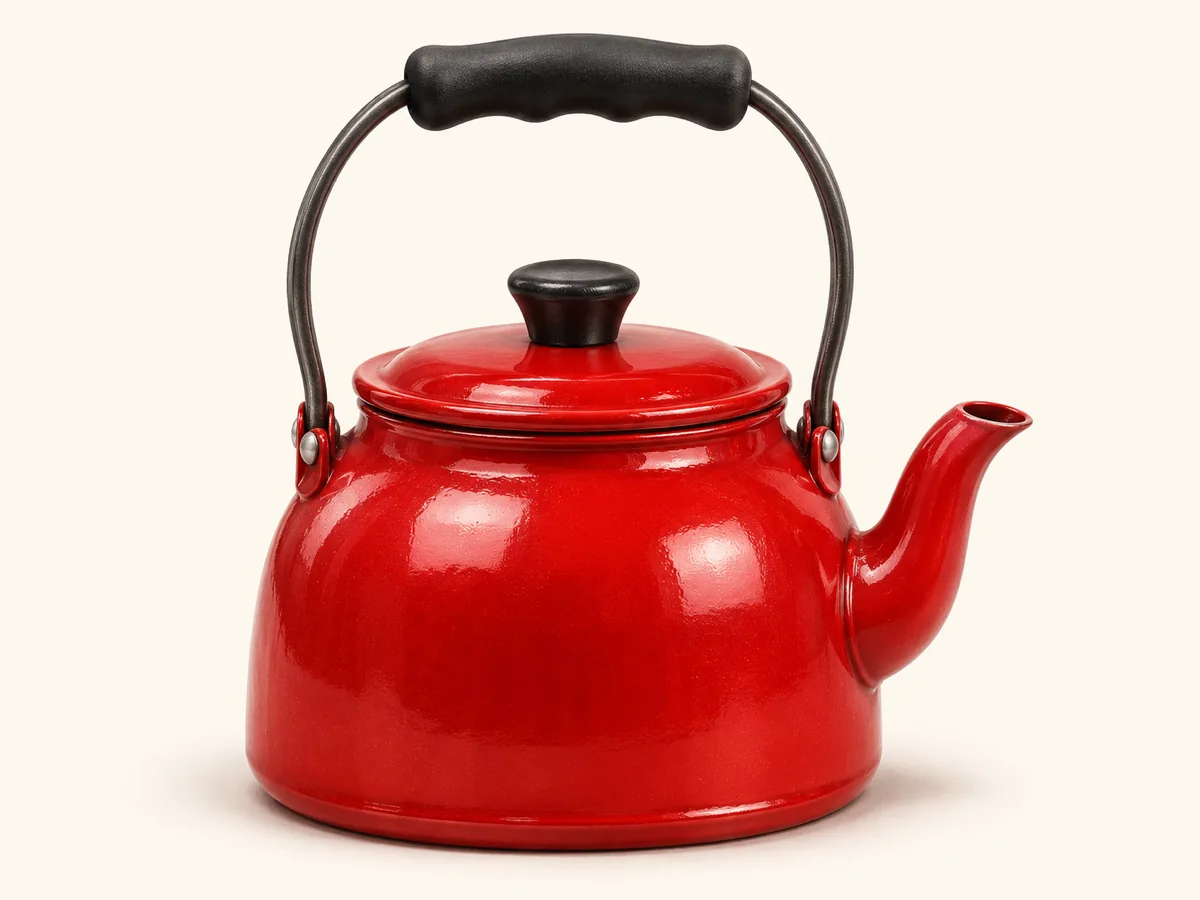
Chaque groupe associe ses images de référence à une illustration statique du plan visé, pas à une vidéo générée. Un robot reste orange dans une librairie. Un sac à dos reste reconnaissable sur un sentier. Une voyageuse, une bouilloire rouge et un camping restent distincts dans un même plan.
Le robot orange marche jusqu’au bureau en bois. Gardez la couleur du robot et la librairie reconnaissables.
Réglages vidéo suggérés : Veo 3.1 Fast · 8 secondes · 16:9 · 2 références
Montrez le sac à dos sur le sentier en forêt. Gardez la forme du sac, les bretelles et la couleur visibles.
Réglages vidéo suggérés : Veo 3.1 Fast · 8 secondes · 16:9 · 2 références
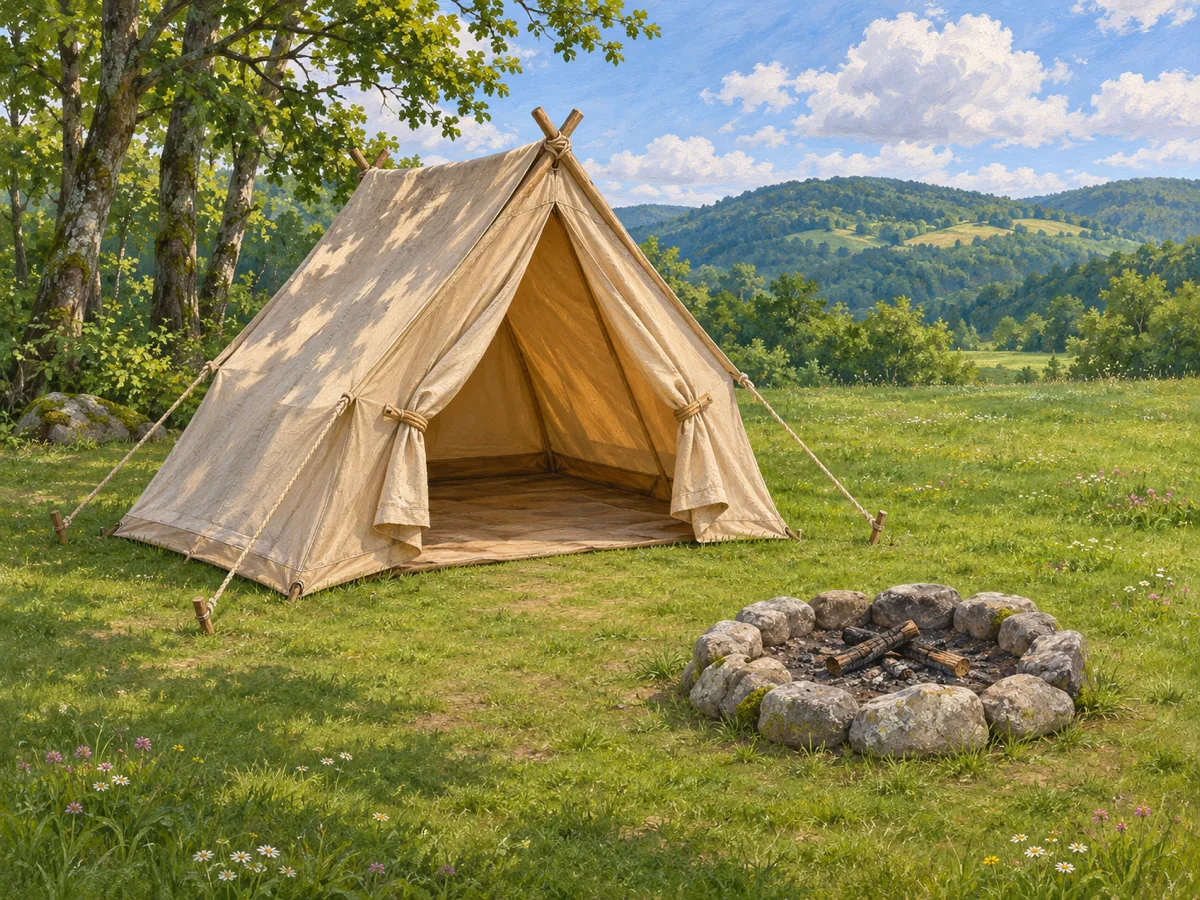
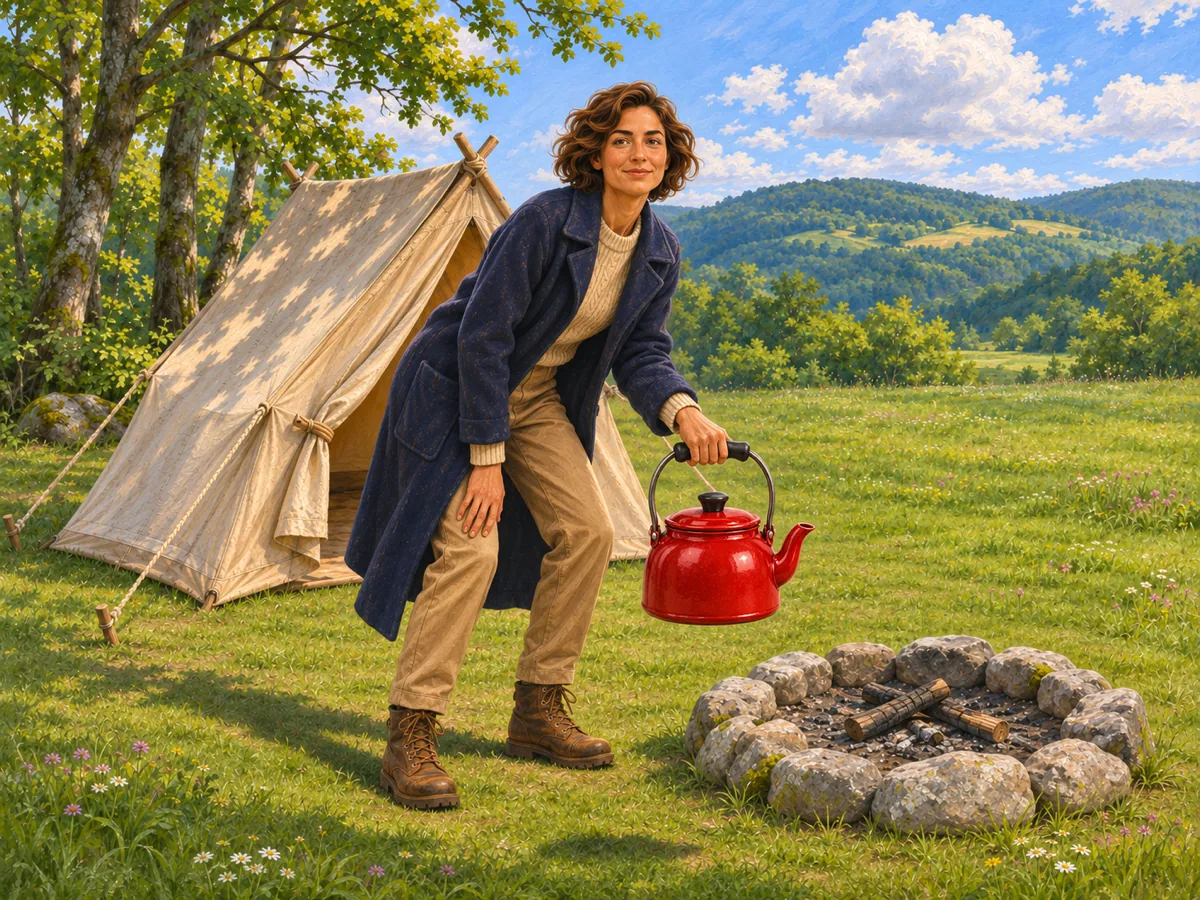
La voyageuse ramasse la bouilloire rouge au camping. Gardez le manteau, la bouilloire et la tente reconnaissables.
Réglages vidéo suggérés : Veo 3.1 Fast · 8 secondes · 9:16 · 3 références
L’IA de référence en vidéo utilise plusieurs images comme guides pour un nouveau plan. Une image peut porter un personnage, une autre un produit, une autre un lieu. Le clip est une nouvelle scène, pas une première image verrouillée ni une dernière image verrouillée.
Une première image unique doit rester le début du plan. La référence en vidéo peut quitter ce cadre tout en gardant le robot orange, le sac à dos ou la bouilloire rouge reconnaissables, pendant que l’action se déroule ailleurs.
Les images guident l’identité, l’objet et le lieu. Elles ne garantissent pas que chaque contour reste identique, et elles ne sont pas enregistrées dans une bibliothèque permanente de personnages. Une note claire sur le sujet de chaque image indique au plan quelle référence est laquelle.
La référence en vidéo de Seedance 3 est l’outil à choisir quand un personnage, un produit et un lieu doivent tous rester fidèles dans un nouveau plan. Une première image unique garde une seule image comme début du clip. Un prompt sans image invente la scène. Un diaporama se contente d’enchaîner des images fixes.
| Référence en vidéo Seedance 3 | Une première image | Vidéo à partir d’un prompt seul | Diaporama de photos | |
|---|---|---|---|---|
| Votre point de départ | Une à trois images | Une seule image | Des mots uniquement | Un empilement d’images fixes |
| Le rôle des images | Guident le personnage, l’objet et le lieu dans un nouveau plan | Verrouille la première image | Aucune image fournie | Apparaissent sous forme de coupes |
| Ce qui peut changer | L’action et la caméra, tandis que les sujets restent reconnaissables | Le mouvement à l’intérieur de ce même cadre | Toute la scène | Seulement l’ordre des coupes |
| Ce que vous récupérez | Un clip de 8 secondes construit à partir de ces références | Un clip de 8 secondes qui s’ouvre sur cette seule image | Un clip d’une scène inventée | Les mêmes images fixes, l’une après l’autre |
Cette page reste sur Veo 3.1 Fast. Ce modèle accepte jusqu’à trois images comme références pour un plan de 8 secondes en 16:9 ou 9:16. Les images servent de guides pour le nouveau plan, pas de première et de dernière image.
Importez une à trois images, nommez le sujet de chacune, décrivez leur rencontre, choisissez 16:9 ou 9:16, puis générez et vérifiez que chaque sujet reste reconnaissable.
Utilisez une à trois images JPEG, PNG ou WebP, chacune de 20MB maximum. Placez le personnage, le produit et le lieu dans l’ordre où vous voulez qu’ils soient lus. Une quatrième image est refusée, afin qu’aucune image de l’ensemble ne soit écartée en silence.
Écrivez une courte note sur chaque image, comme le robot orange ou la bouilloire rouge. La note est ajoutée au prompt dans ce même ordre. C’est du texte simple, pas un identifiant de personnage enregistré.
Dites ce que font les sujets ensemble. Le robot marche jusqu’au bureau. La voyageuse ramasse la bouilloire. Remplacer une image conserve les autres images et les mots que vous avez déjà écrits.
Prévisualisez le clip de 8 secondes et téléchargez-le. Vérifiez la couleur du robot, les bretelles du sac à dos ou la bouilloire rouge. Si un sujet a disparu, ajustez cette note ou l’action et générez à nouveau. Le dernier clip terminé reste disponible jusqu’à ce que le nouveau soit prêt.
La référence en vidéo construit un nouveau court clip à partir d’une à trois images. Chaque image guide un personnage, un objet ou un lieu. Sur Seedance 3, le résultat est un plan de 8 secondes, pas un diaporama ni une première image verrouillée.
C’est le workflow qui garde plusieurs références reconnaissables dans une même nouvelle scène. Vous importez les images, nommez chaque sujet et décrivez l’action. Le modèle utilise ces images comme guides, et non comme première et dernière images.
Importez le personnage, le produit et le lieu sous forme d’images séparées. Nommez chacun, décrivez l’action, choisissez 16:9 ou 9:16, puis lancez la génération. Vérifiez ensuite que le manteau, le produit et le lieu sont toujours reconnaissables.
Une première image démarre le clip sur cette image exacte. La référence en vidéo peut mettre en scène une nouvelle action, les sujets venant des images que vous avez importées. Utilisez une première image quand la photo elle-même doit être le début du plan.
Une, deux ou trois images JPEG, PNG ou WebP. Chaque fichier doit faire 20MB maximum et s’ouvrir sur votre appareil. Zéro image ou une quatrième image sont bloquées avant le début de la génération.
Non. La note est un texte du prompt, écrit sous la forme Référence 1, Référence 2 et Référence 3 dans l’ordre affiché sur la page. Elle indique au plan quelle image est laquelle. Elle n’est pas enregistrée comme une identité réutilisable.
Veo 3.1 Fast génère un clip de 8 secondes en 16:9 ou 9:16. Cette page ne change pas de modèle, car un autre modèle traiterait les images comme des images de début et de fin plutôt que comme des références.
Les sujets devraient rester reconnaissables : la couleur du robot, la forme du sac à dos, la bouilloire rouge. Les visages, les textes et les petits contours peuvent encore varier. Vérifiez l’aperçu, puis modifiez une note ou l’action si un sujet a disparu.