
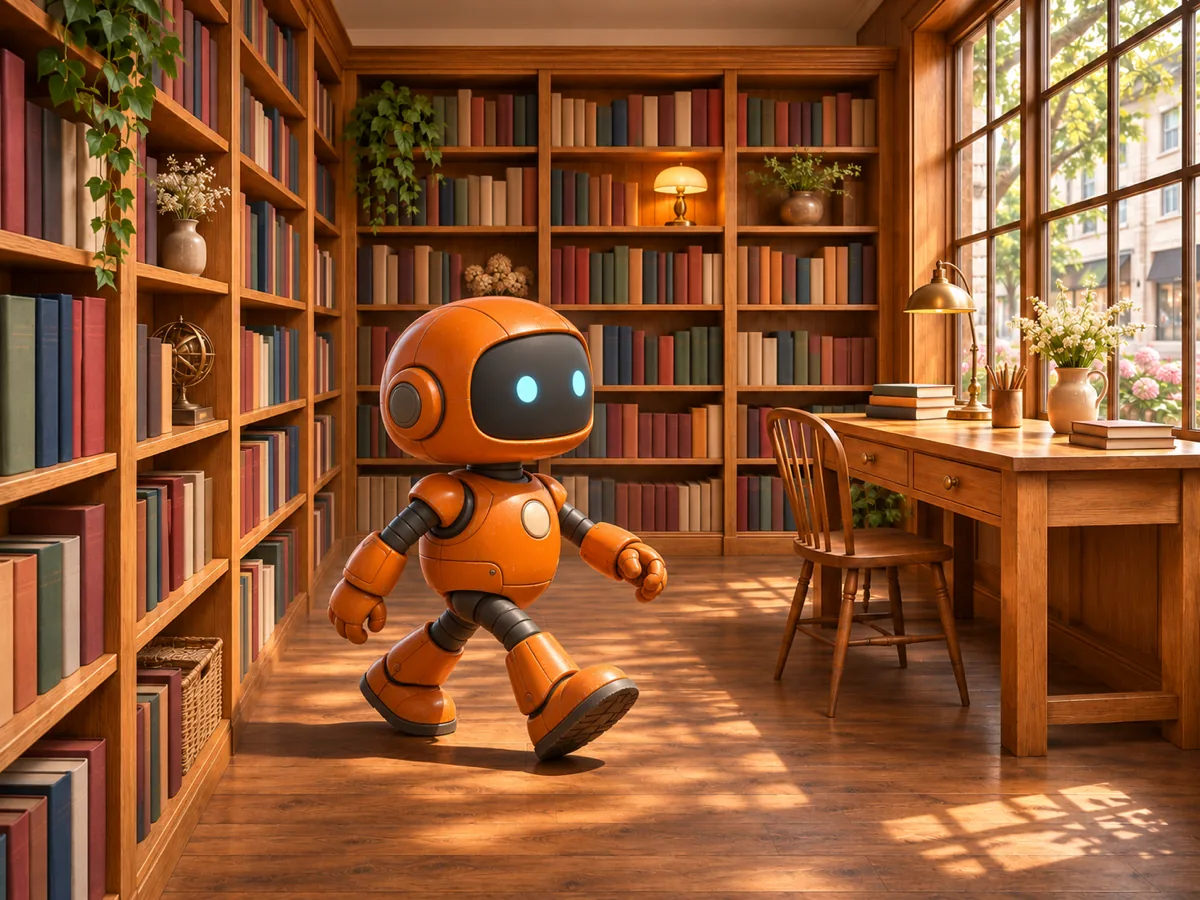
Un robot naranja camina hasta un escritorio de librería
El robot naranja camina hasta el escritorio de madera. Mantén reconocibles el color del robot y la librería.
Ajustes de vídeo sugeridos: Veo 3.1 Fast · 8 segundos · 16:9 · 2 referencias
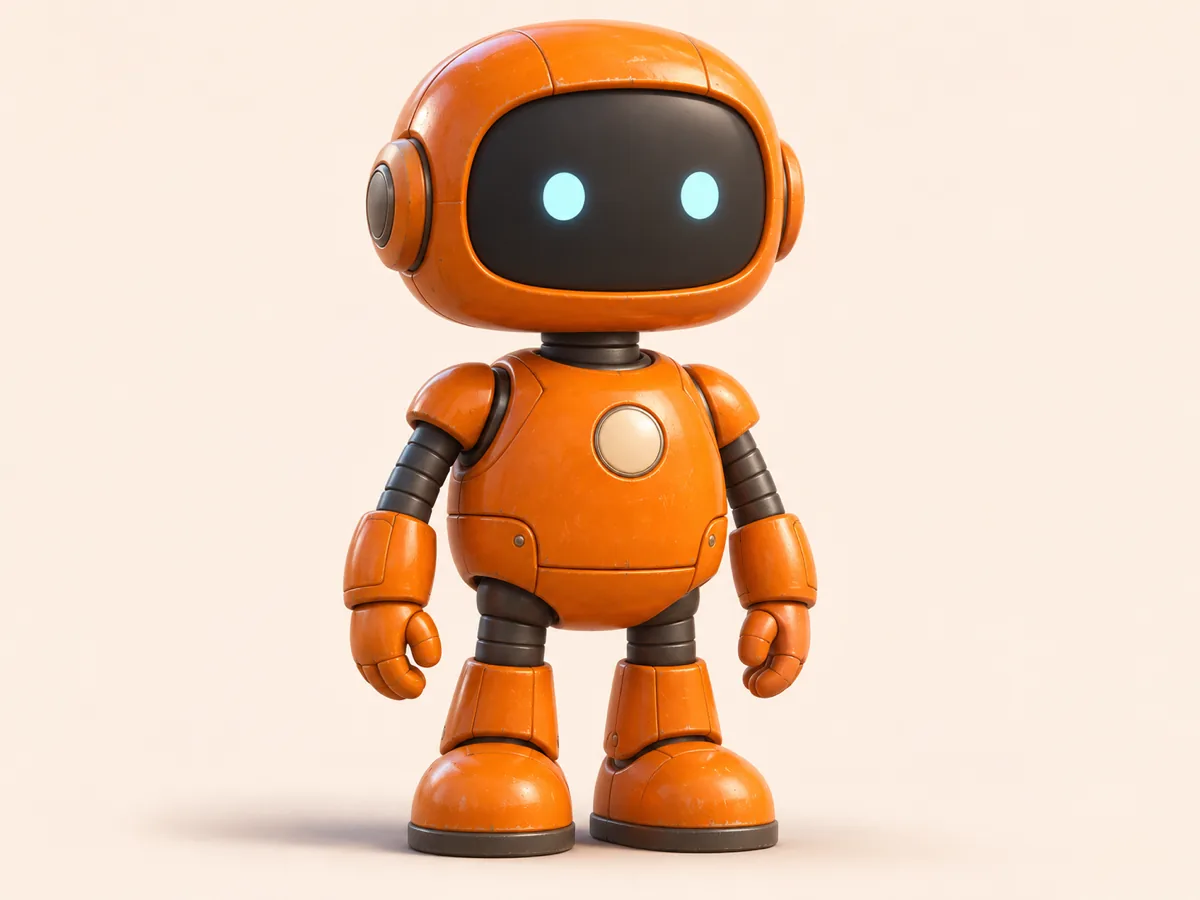
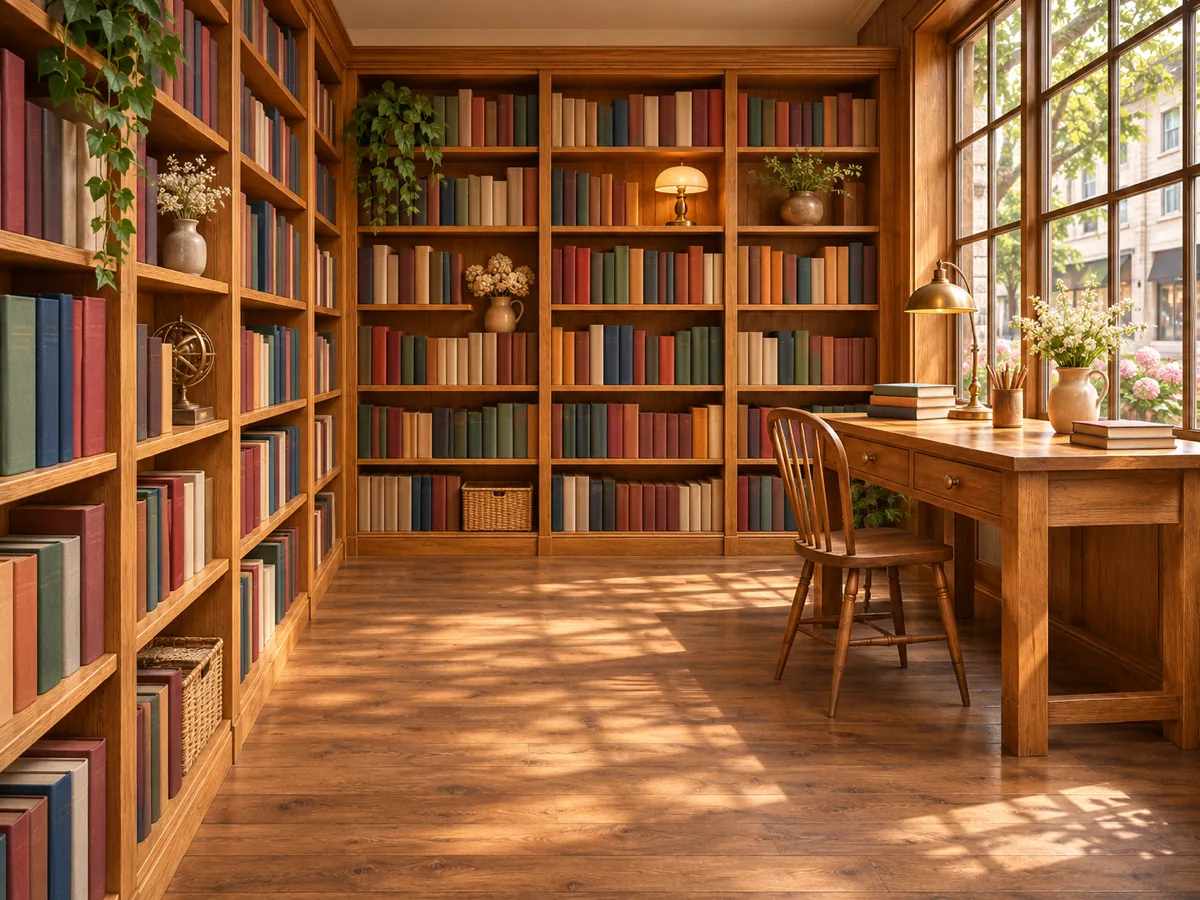
De referencia a vídeo usa fotos de un personaje, un producto y un lugar como guía de un plano nuevo. Sube de una a tres imágenes, di qué es cada una y descarga un clip de 8 segundos.
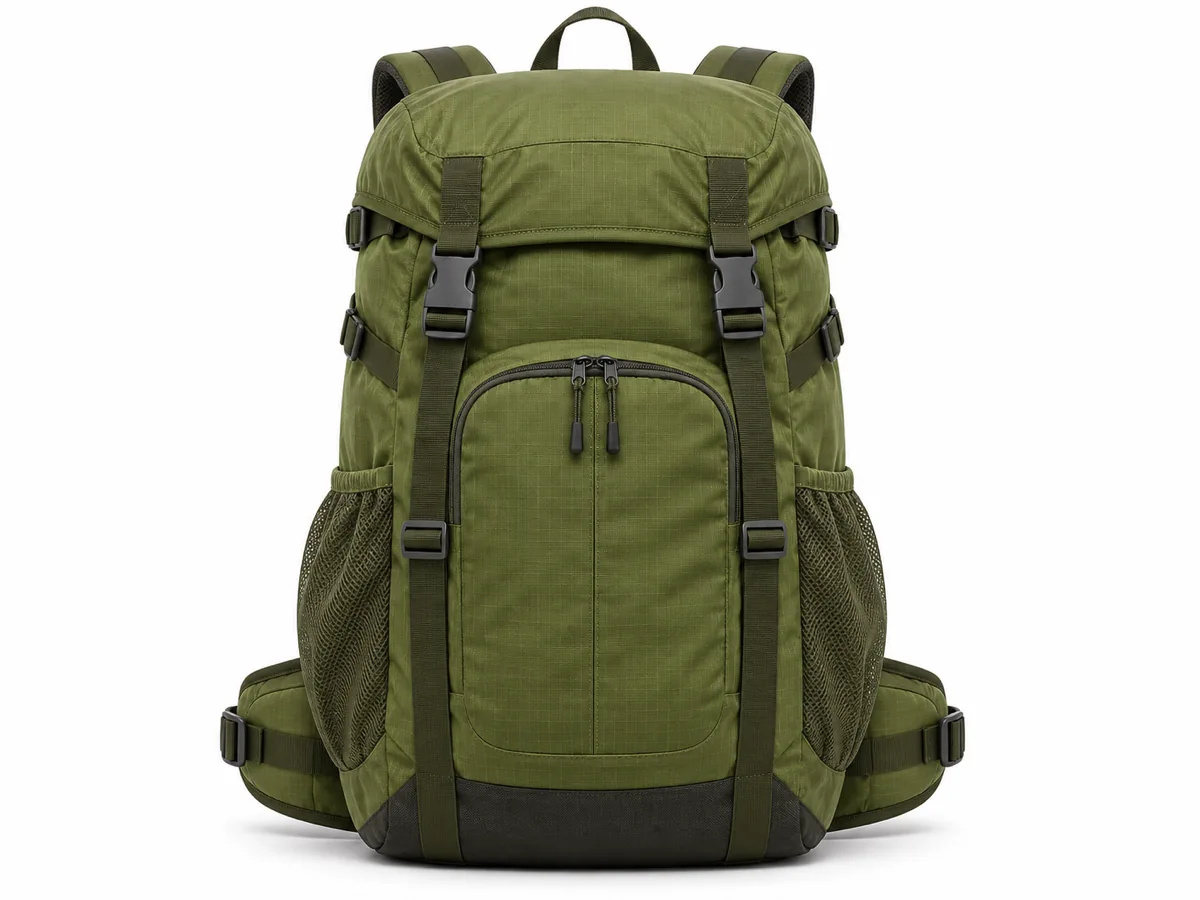
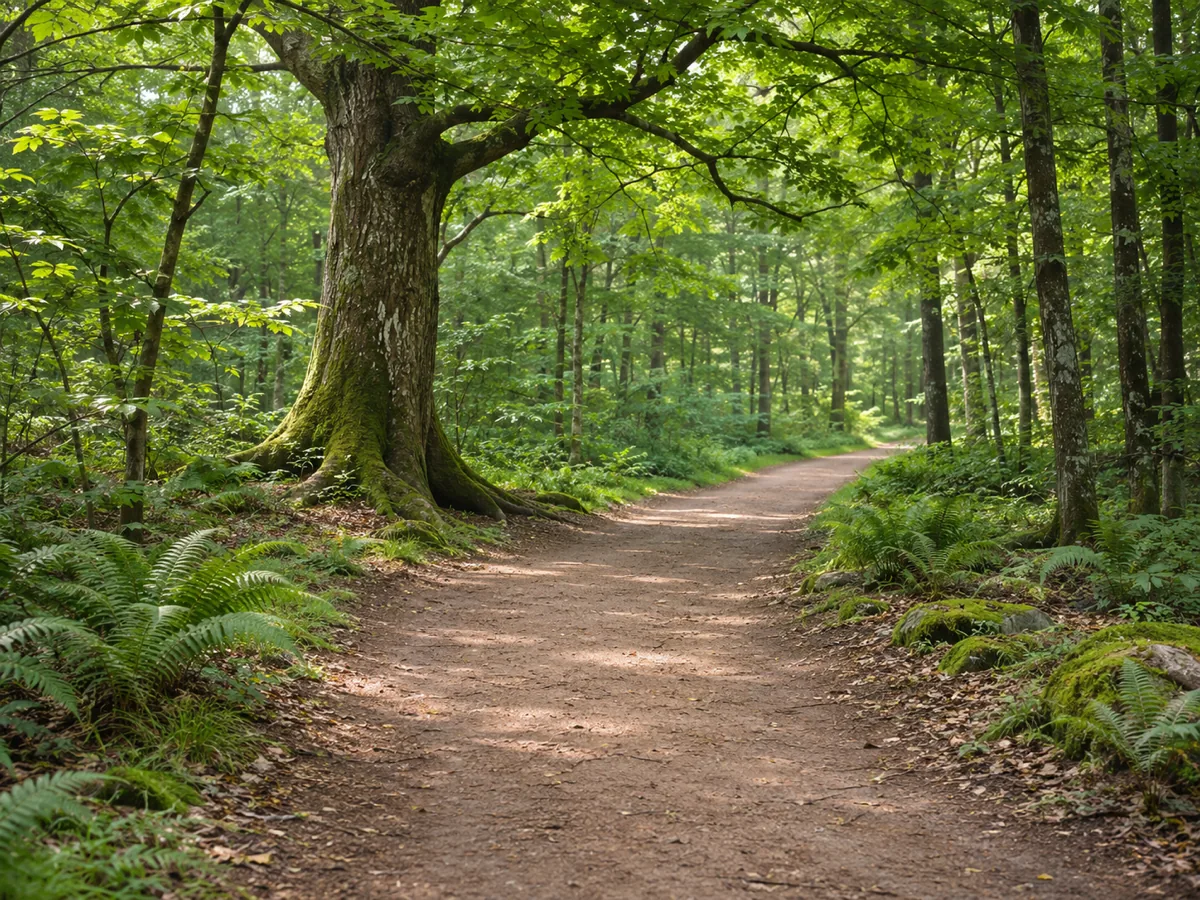
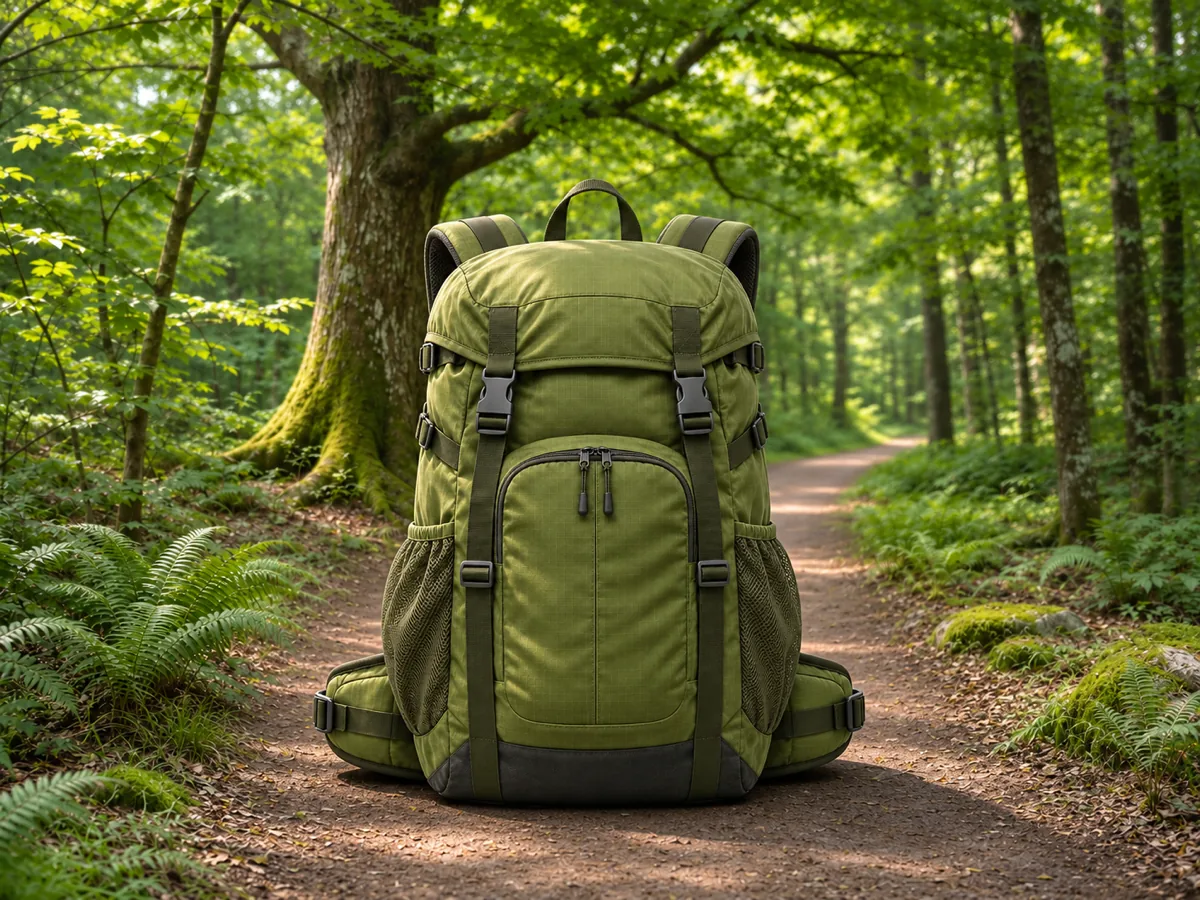
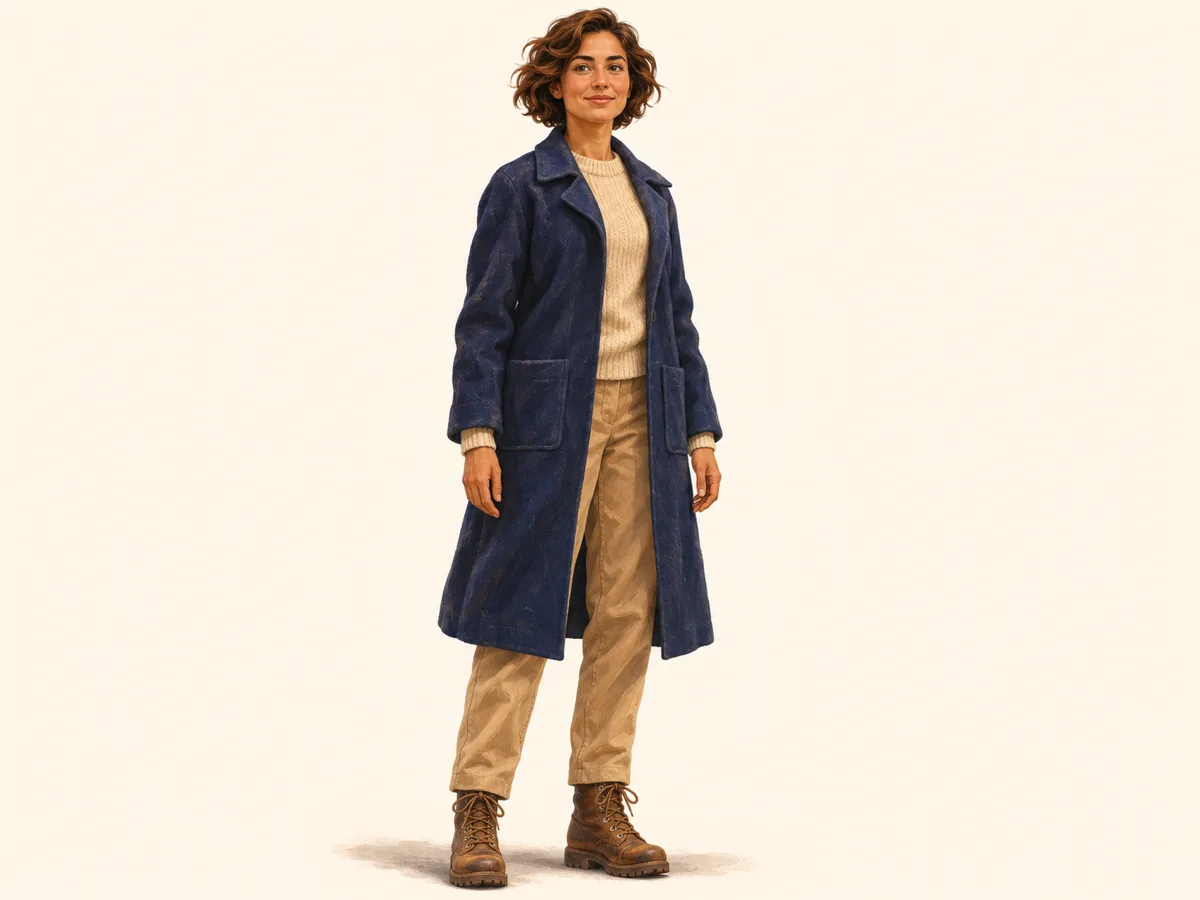
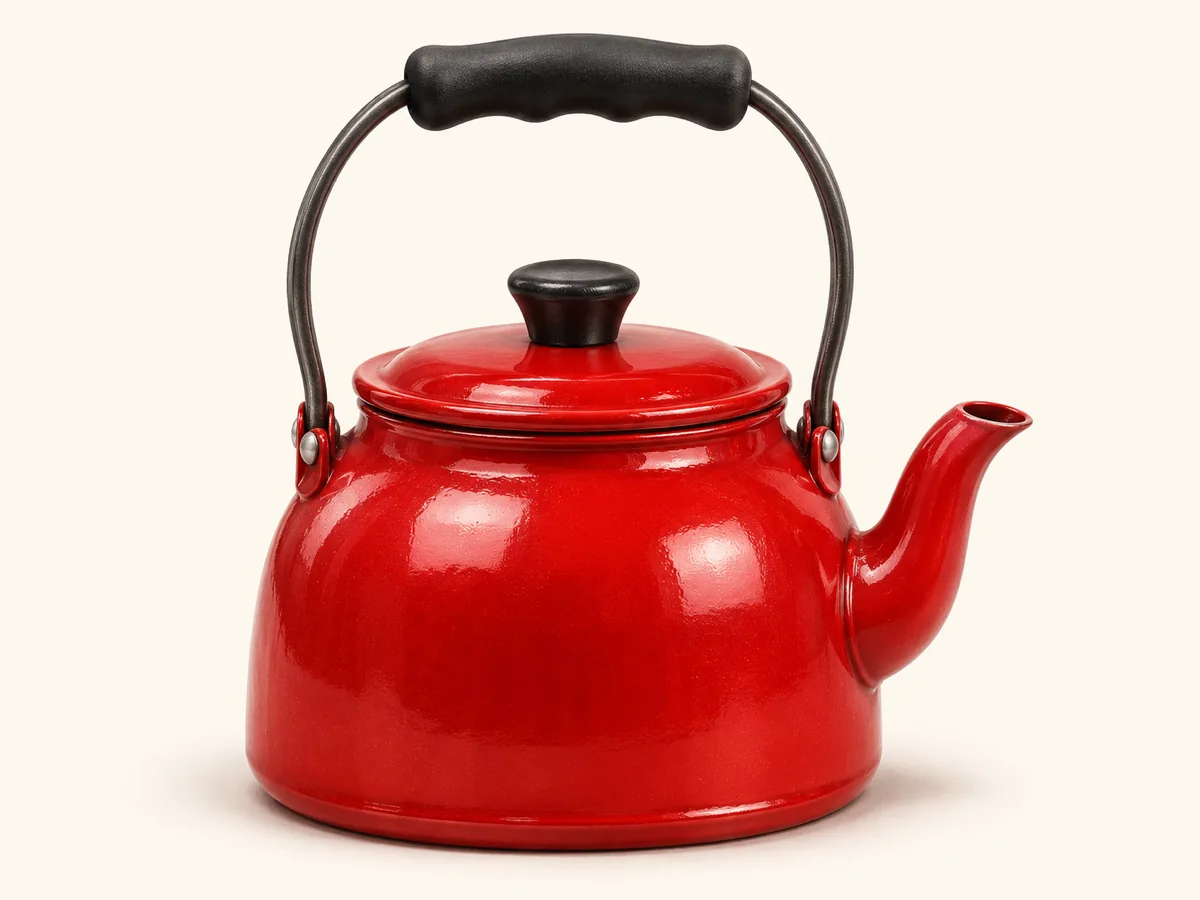
Cada grupo combina sus imágenes de referencia con una ilustración estática del plano previsto, no un vídeo generado. Un robot sigue siendo naranja dentro de una librería. Una mochila sigue siendo reconocible en un sendero. Un viajero, una tetera roja y un campamento se distinguen bien en un mismo plano.
El robot naranja camina hasta el escritorio de madera. Mantén reconocibles el color del robot y la librería.
Ajustes de vídeo sugeridos: Veo 3.1 Fast · 8 segundos · 16:9 · 2 referencias
Muestra la mochila en el sendero del bosque. Mantén visibles la forma, las correas y el color de la mochila.
Ajustes de vídeo sugeridos: Veo 3.1 Fast · 8 segundos · 16:9 · 2 referencias
El viajero recoge la tetera roja en el campamento. Mantén reconocibles el abrigo, la tetera y la tienda.
Ajustes de vídeo sugeridos: Veo 3.1 Fast · 8 segundos · 9:16 · 3 referencias
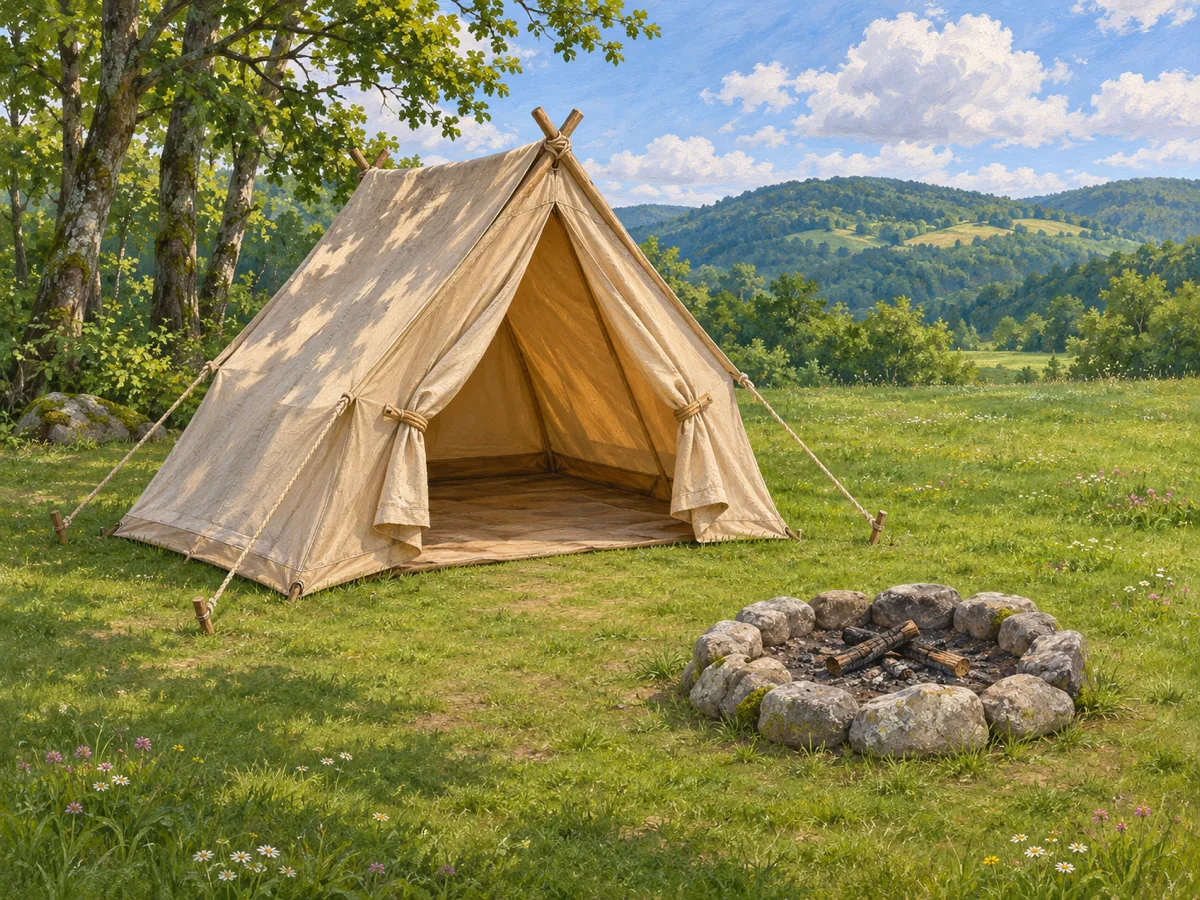
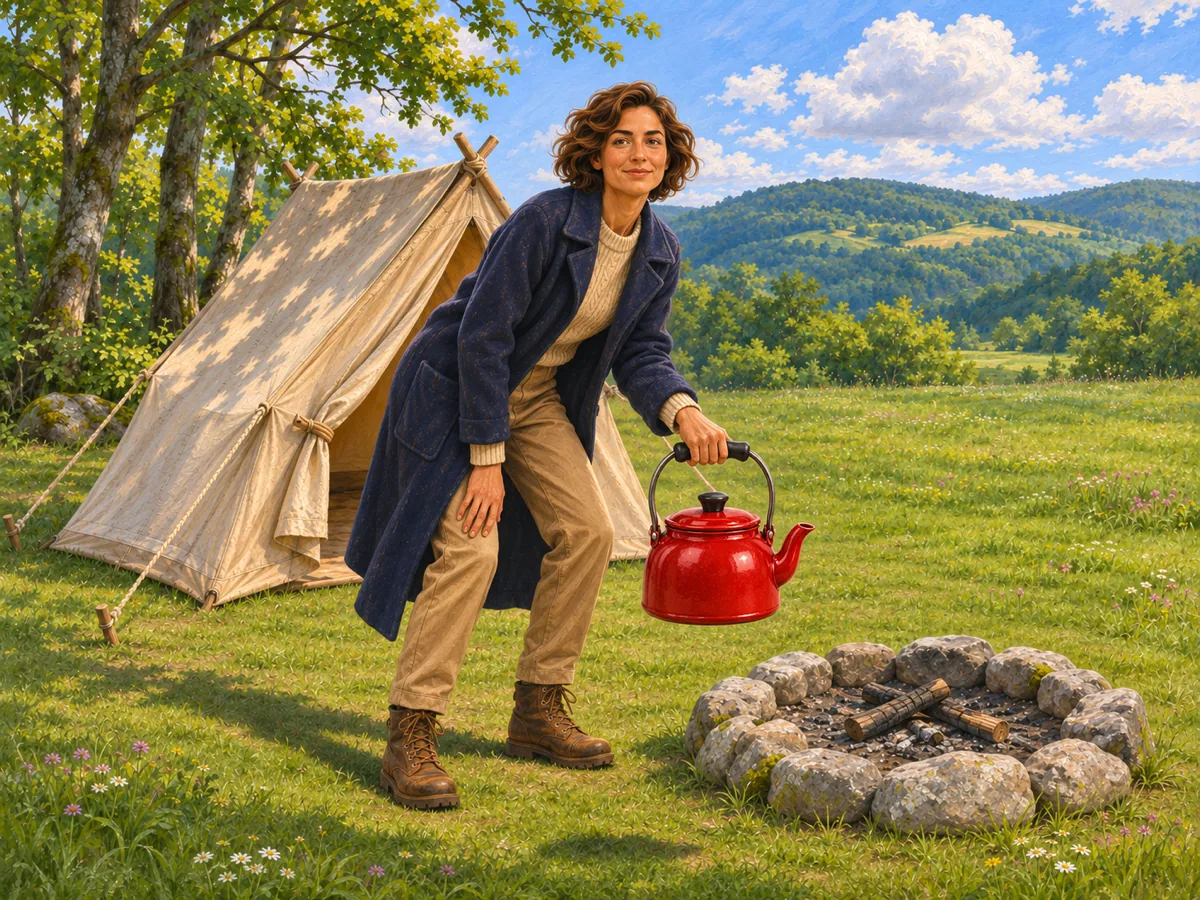
La IA de referencia a vídeo usa varias imágenes como guías para un plano nuevo. Una imagen puede aportar un personaje, otra un producto y otra un lugar. El clip es una escena nueva, no un primer fotograma fijado ni un último fotograma fijado.
Un único primer fotograma tiene que seguir siendo el comienzo del plano. De referencia a vídeo puede salirse de ese fotograma y aun así mantener reconocibles el robot naranja, la mochila o la tetera roja mientras la acción ocurre en otro sitio.
Las imágenes guían la identidad, el objeto y el lugar. No garantizan que cada borde se mantenga idéntico, y no se guardan como una biblioteca permanente de personajes. Una nota clara sobre el sujeto en cada imagen le indica al plano qué referencia es cuál.
De referencia a vídeo de Seedance 3 es la opción adecuada cuando un personaje, un producto y un lugar tienen que conservarse dentro de un plano nuevo. Un primer fotograma mantiene una sola imagen como arranque del clip. Un prompt sin imágenes inventa la escena. Una presentación de fotos solo corta de una imagen fija a otra.
| De referencia a vídeo de Seedance 3 | Un primer fotograma | Vídeo solo con prompt | Presentación de fotos | |
|---|---|---|---|---|
| Con qué empiezas | De una a tres imágenes | Una imagen | Solo palabras | Una pila de imágenes fijas |
| Qué hacen las imágenes | Guían al personaje, al objeto y al lugar en un plano nuevo | Fijan el primer fotograma | No se aporta nada | Aparecen como cortes |
| Qué puede cambiar | La acción y la cámara, mientras los sujetos siguen siendo reconocibles | El movimiento dentro de ese mismo encuadre | Toda la escena | Solo el orden de los cortes |
| Qué te llevas | Un clip de 8 segundos creado a partir de esas referencias | Un clip de 8 segundos que empieza en esa única imagen | Un clip de una escena inventada | Las mismas imágenes fijas, una tras otra |
Esta página se queda con Veo 3.1 Fast. Ese modelo admite hasta tres imágenes como referencias para un plano de 8 segundos en 16:9 o 9:16. Las imágenes son guías para el plano nuevo, no un primer fotograma y un último fotograma.
Sube de una a tres imágenes, nombra el sujeto de cada una, describe cómo se encuentran, elige 16:9 o 9:16, y luego genera y comprueba que cada sujeto sigue siendo reconocible.
Usa de una a tres imágenes JPEG, PNG o WebP, de hasta 20MB cada una. Pon el personaje, el producto y el lugar en el orden en que quieras que se lean. Se rechaza una cuarta imagen, para que ninguna del conjunto se descarte en silencio.
Escribe una nota breve en cada imagen, como el robot naranja o la tetera roja. La nota se añade al prompt en ese mismo orden. Es texto sin formato, no un ID de personaje guardado.
Di qué hacen los sujetos juntos. El robot camina hasta el escritorio. El viajero recoge la tetera. Al sustituir una imagen se conservan las demás y las palabras que ya escribiste.
Previsualiza el clip de 8 segundos y descárgalo. Fíjate en el color del robot, las correas de la mochila o la tetera roja. Si un sujeto ha desaparecido, ajusta esa nota o la acción y vuelve a generar. El último clip terminado se conserva hasta que el nuevo se genere correctamente.
Referencia a vídeo crea un clip corto nuevo a partir de una a tres imágenes. Cada imagen guía a un personaje, un objeto o un lugar. En Seedance 3 el resultado es un plano de 8 segundos, no una presentación de fotos ni un primer fotograma fijado.
Es el flujo de trabajo que mantiene reconocibles varias referencias dentro de una escena nueva. Subes las imágenes, nombras cada sujeto y describes la acción. El modelo usa esas imágenes como guías, no como primer y último fotograma.
Sube el personaje, el producto y el lugar como imágenes separadas. Nombra cada una, describe la acción, elige 16:9 o 9:16 y genera. Después comprueba que el abrigo, el producto y el lugar siguen siendo reconocibles.
Un primer fotograma inicia el clip exactamente en esa imagen. De referencia a vídeo puede escenificar una acción nueva mientras los sujetos proceden de las imágenes que subiste. Usa un único fotograma cuando la propia foto tenga que ser el comienzo del plano.
Una, dos o tres imágenes JPEG, PNG o WebP. Cada archivo debe pesar 20MB o menos y abrirse en tu dispositivo. Cero imágenes y una cuarta imagen se detienen antes de que empiece la generación.
No. La nota es texto dentro del prompt, escrito como Referencia 1, Referencia 2 y Referencia 3 en el orden que se muestra en la página. Le indica al plano qué imagen es cuál. No se guarda como una identidad reutilizable.
Veo 3.1 Fast crea un clip de 8 segundos en 16:9 o 9:16. Esta página no cambia ese modelo, porque otro modelo trataría las imágenes como fotogramas en lugar de como referencias.
Los sujetos deberían seguir siendo reconocibles: el color del robot, la forma de la mochila, la tetera roja. Los rostros, las etiquetas y los bordes pequeños aún pueden variar. Revisa la vista previa y cambia una nota o la acción si se ha perdido algún sujeto.